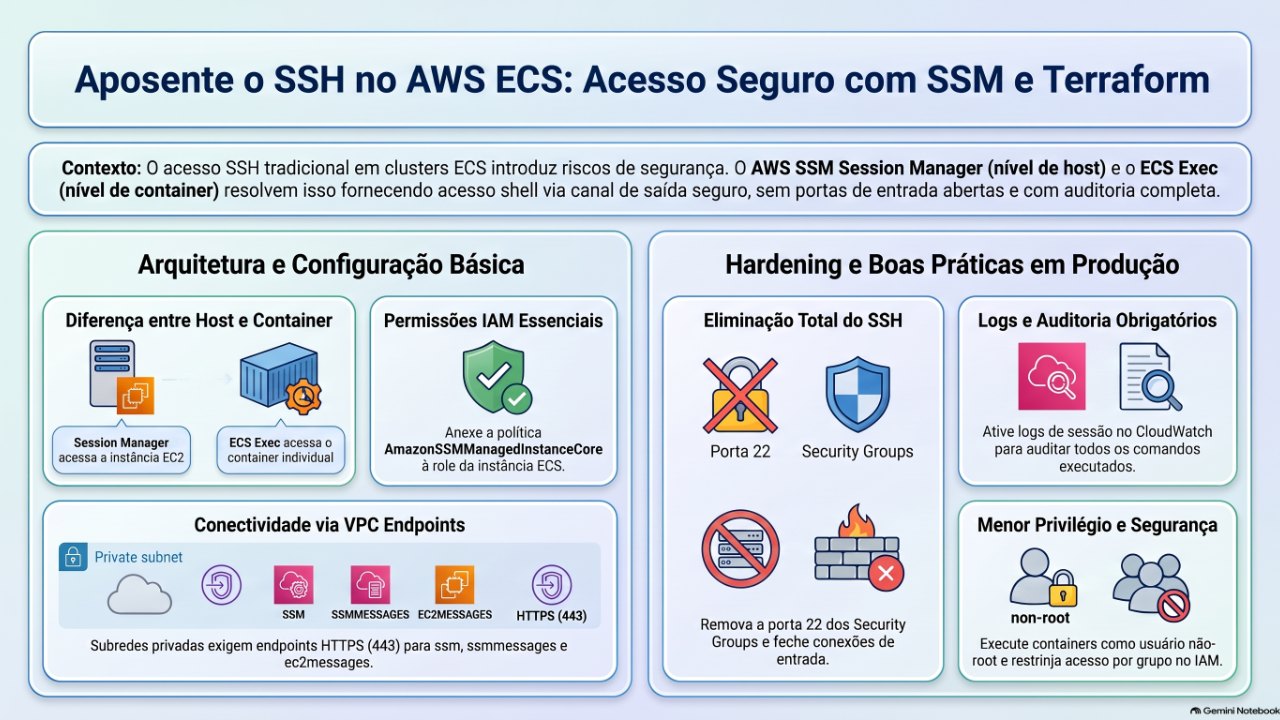
Aposente o SSH no ECS: Session Manager e ECS Exec com Terraform
Acesse o shell dos hosts ECS e abra um Rails console dentro dos containers sem abrir nenhuma porta de entrada, sem distribuir chaves SSH e sem perder a trilha de auditoria.
A maioria dos setups de ECS em EC2 que já vi ainda carrega algum legado de SSH: um key pair no launch template, a porta 22 aberta para um bastion e ninguém sabendo direito quem ainda tem a chave privada.
O Session Manager do AWS Systems Manager (SSM) substitui tudo isso por sessões controladas por IAM e registradas em log, sobre um canal apenas de saída. O ECS Exec usa a mesma base para abrir um shell dentro de um container em execução, que é exatamente o que você quer quando precisa de um rails console em staging.
Este post mostra como habilitar os dois com Terraform, incluindo as pegadinhas que encontrei pelo caminho. Todos os nomes, IDs e regiões abaixo são placeholders.
Duas coisas diferentes, a mesma base
- Session Manager no host: shell na instância EC2 do cluster. Exige o SSM Agent no host e permissões na instance role.
- ECS Exec: shell em um container específico de uma task em execução. Exige permissões na task role,
enable_execute_commandno service e, opcionalmente, logging configurado no cluster.
Ambos precisam de HTTPS de saída para os endpoints do SSM. Você pode habilitar cada um de forma independente.
Pré-requisitos
- Instâncias do ECS rodando a AMI ECS-optimized Amazon Linux 2023 (ou AL2). O SSM Agent já vem instalado e habilitado.
- Saída na porta 443 das instâncias e tasks para
ssm,ssmmessageseec2messages, via NAT ou VPC interface endpoints. - AWS CLI v2 e o plugin do Session Manager na sua máquina.
Passo 1: Dar acesso ao SSM para a instance role
Uma única managed policy basta para o agent se registrar:
resource "aws_iam_role_policy_attachment" "ecs_instance_ssm" {
  role       = aws_iam_role.ecs_instance.name
  policy_arn = "arn:aws:iam::aws:policy/AmazonSSMManagedInstanceCore"
}
Se as instance roles são criadas dentro de um módulo por capacity group (high-memory, general purpose etc.), coloque o attachment dentro do módulo para que todos os grupos recebam.
Verifique também se a role usa managed_policy_arns ou aws_iam_role_policy_attachments_exclusive. Se usar, adicione o ARN nessa lista, senão os dois vão brigar a cada apply.
Não precisa reiniciar. O agent tenta o registro de novo sozinho e normalmente aparece em poucos minutos.
Passo 2: Subnets privadas precisam de VPC endpoints
Se as instâncias ou tasks não têm NAT, adicione interface endpoints:
locals {
  ssm_services = ["ssm", "ssmmessages", "ec2messages"]
}

resource "aws_vpc_endpoint" "ssm" {
  for_each            = toset(local.ssm_services)
  vpc_id              = var.vpc_id
  service_name        = "com.amazonaws.${var.region}.${each.key}"
  vpc_endpoint_type   = "Interface"
  subnet_ids          = var.private_subnet_ids
  security_group_ids  = [aws_security_group.vpce.id]
  private_dns_enabled = true
}
O security group do endpoint precisa liberar entrada na 443 a partir dos security groups das instâncias e das tasks. Se você grava sessões no CloudWatch ou criptografa com KMS, adicione também os endpoints logs e kms.
Passo 3: Permissões na task role para o ECS Exec
O SSM agent dentro do container usa a task role, não a instance role:
data "aws_iam_policy_document" "ecs_exec" {
  statement {
    actions = [
      "ssmmessages:CreateControlChannel",
      "ssmmessages:CreateDataChannel",
      "ssmmessages:OpenControlChannel",
      "ssmmessages:OpenDataChannel",
    ]
    resources = ["*"]
  }

  statement {
    actions = [
      "logs:DescribeLogGroups",
      "logs:CreateLogStream",
      "logs:DescribeLogStreams",
      "logs:PutLogEvents",
    ]
    resources = ["*"]
  }
}

resource "aws_iam_role_policy" "ecs_exec" {
  name   = "ecs-exec"
  role   = aws_iam_role.task.id
  policy = data.aws_iam_policy_document.ecs_exec.json
}
Na vida real, restrinja o statement de logs ao ARN do log group de exec. Se o log group for criptografado com KMS, adicione kms:Decrypt nessa chave.
Passo 4: Logging no cluster e a flag no service
resource "aws_cloudwatch_log_group" "ecs_exec" {
  name              = "ecs-execute-command-${var.environment}"
  retention_in_days = 90
}

resource "aws_ecs_cluster" "this" {
  name = var.cluster_name

  configuration {
    execute_command_configuration {
      logging = "OVERRIDE"

      log_configuration {
        cloud_watch_log_group_name = aws_cloudwatch_log_group.ecs_exec.name
      }
    }
  }
}

resource "aws_ecs_service" "console" {
  name                   = "rails-console-${var.environment}"
  cluster                = aws_ecs_cluster.this.id
  task_definition        = aws_ecs_task_definition.console.arn
  enable_execute_command = true
  # ...
}
Importante:
enable_execute_commandsó vale para tasks iniciadas depois da mudança. As tasks existentes continuam rodando sem ele. Force um novo deployment assim que o apply terminar.
Passo 5: Acesso para pessoas
Associe esta policy a um grupo IAM (por exemplo staging-operators), não a usuários individuais:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["ecs:ExecuteCommand", "ecs:DescribeTasks", "ecs:ListTasks"],
      "Resource": [
        "arn:aws:ecs:<REGION>:<ACCOUNT_ID>:cluster/staging",
        "arn:aws:ecs:<REGION>:<ACCOUNT_ID>:task/staging/*"
      ]
    },
    {
      "Effect": "Allow",
      "Action": "ssm:StartSession",
      "Resource": [
        "arn:aws:ec2:<REGION>:<ACCOUNT_ID>:instance/*",
        "arn:aws:ssm:<REGION>:<ACCOUNT_ID>:document/SSM-SessionManagerRunShell"
      ],
      "Condition": {
        "StringEquals": { "ssm:resourceTag/Environment": "staging" }
      }
    },
    {
      "Effect": "Allow",
      "Action": ["ssm:TerminateSession", "ssm:ResumeSession"],
      "Resource": "arn:aws:ssm:*:<ACCOUNT_ID>:session/${aws:username}-*"
    }
  ]
}
Antes de adicionar qualquer coisa, confira o que você já tem:
aws iam simulate-principal-policy \
  --policy-source-arn arn:aws:iam::<ACCOUNT_ID>:user/<YOUR_USER> \
  --action-names ecs:ExecuteCommand ssm:StartSession \
  --query 'EvaluationResults[].[EvalActionName,EvalDecision]' --output table
Passo 6: Suba pelo CI, não pelo seu laptop
Se o time roda Terraform só via pipeline (e deveria), valide localmente sem tocar no state:
terraform fmt -recursive
terraform init -backend=false
terraform validate
Depois abra um merge request e leia o plan com atenção. Você deve ver apenas as suas adições. Qualquer outra coisa é drift de mudanças manuais: sinalize em vez de aplicar.
Pegadinha: "log group already exists"
Se alguém já tinha habilitado o logging de exec pelo console, o apply falha com ResourceAlreadyExistsException. Não apague o grupo. Importe com um bloco import (Terraform 1.5+) para que o pipeline passe a gerenciá-lo:
import {
  to = aws_cloudwatch_log_group.ecs_exec
  id = "ecs-execute-command-staging"
}
O esperado é 1 to import, 0 to add, 0 to change. Remova o bloco em um MR seguinte. Atenção: blocos de import valem para todo workspace que usa o root module, então confira os outros ambientes antes.
Passo 7: Conectando
Instale o lado cliente no macOS:
brew install awscli
brew install --cask session-manager-plugin
Confirme que os hosts estão registrados:
aws ssm describe-instance-information \
  --query 'InstanceInformationList[].[InstanceId,PingStatus,AgentVersion]' \
  --output table
Shell em um host:
aws ssm start-session --target <INSTANCE_ID>
Shell em um container (olá, rails console):
TASK=$(aws ecs list-tasks --cluster staging \
  --service-name rails-console-staging \
  --query 'taskArns[0]' --output text)

aws ecs execute-command --cluster staging --task "$TASK" \
  --container rails-console-staging --interactive \
  --command "/bin/bash"
Troubleshooting
| Erro | Causa provável |
|---|---|
execute command was not enabled when the task was run | A task é anterior ao enable_execute_command. Force um novo deployment. |
TargetNotConnectedException | Task role sem ssmmessages:*, configuração de logging de exec quebrada (log group ou permissões de log faltando), sem rota para ssmmessages, ou task antiga. Rode o script amazon-ecs-exec-checker da AWS. |
Instância não aparece no describe-instance-information | Instance role sem AmazonSSMManagedInstanceCore, ou sem caminho de rede. Veja /var/log/amazon/ssm/amazon-ssm-agent.log. |
Erro de regex InvalidInstanceId ao filtrar por IDs | A saída em texto da CLI separa IDs com tab, e o zsh não faz word-splitting. Normalize com tr -s '[:space:]' ','. |
SessionManagerPlugin is not found | Plugin fora do PATH. Reinstale ou abra um novo shell. |
| Os recursos existem mas a CLI não enxerga | Região errada. Confira AWS_REGION e o seu profile. |
Antes de levar para produção
- Ative o logging de sessões e confirme que os streams estão chegando de fato. Acesso a shell em produção precisa ser auditável.
- Grupo IAM separado para produção, de preferência atrás de SSO com MFA.
- Restrinja o exec por nome de container com a condition
ecs:container-name, limitando o acesso aos containers de console. - Rode os containers com um
USERnão root. O ECS Exec te coloca como o usuário com que o container roda. - Bloqueie o acesso dos containers às credenciais IMDS do host (bloqueio de IMDS no awsvpc ou hop limit 1), para que as tasks não peguem carona nas permissões de SSM da instance role.
- Remova a porta 22 dos security groups e o key pair do launch template. Essa é a recompensa.
- Mantenha o SSM Agent atualizado: uma association do State Manager com
AWS-UpdateSSMAgent, ou refresh regular das AMIs.
Conclusão
A mudança inteira é um punhado de statements IAM, três VPC endpoints, um bloco no cluster e uma flag no service. O tempo se perde em outros lugares: tasks anteriores à flag, log groups criados à mão e manias do shell. Codifique uma vez em um módulo, suba pelo CI e você nunca mais vai precisar distribuir uma chave SSH.
Comentários
Faça login com GitHub para comentar.
Ainda não há comentários.